
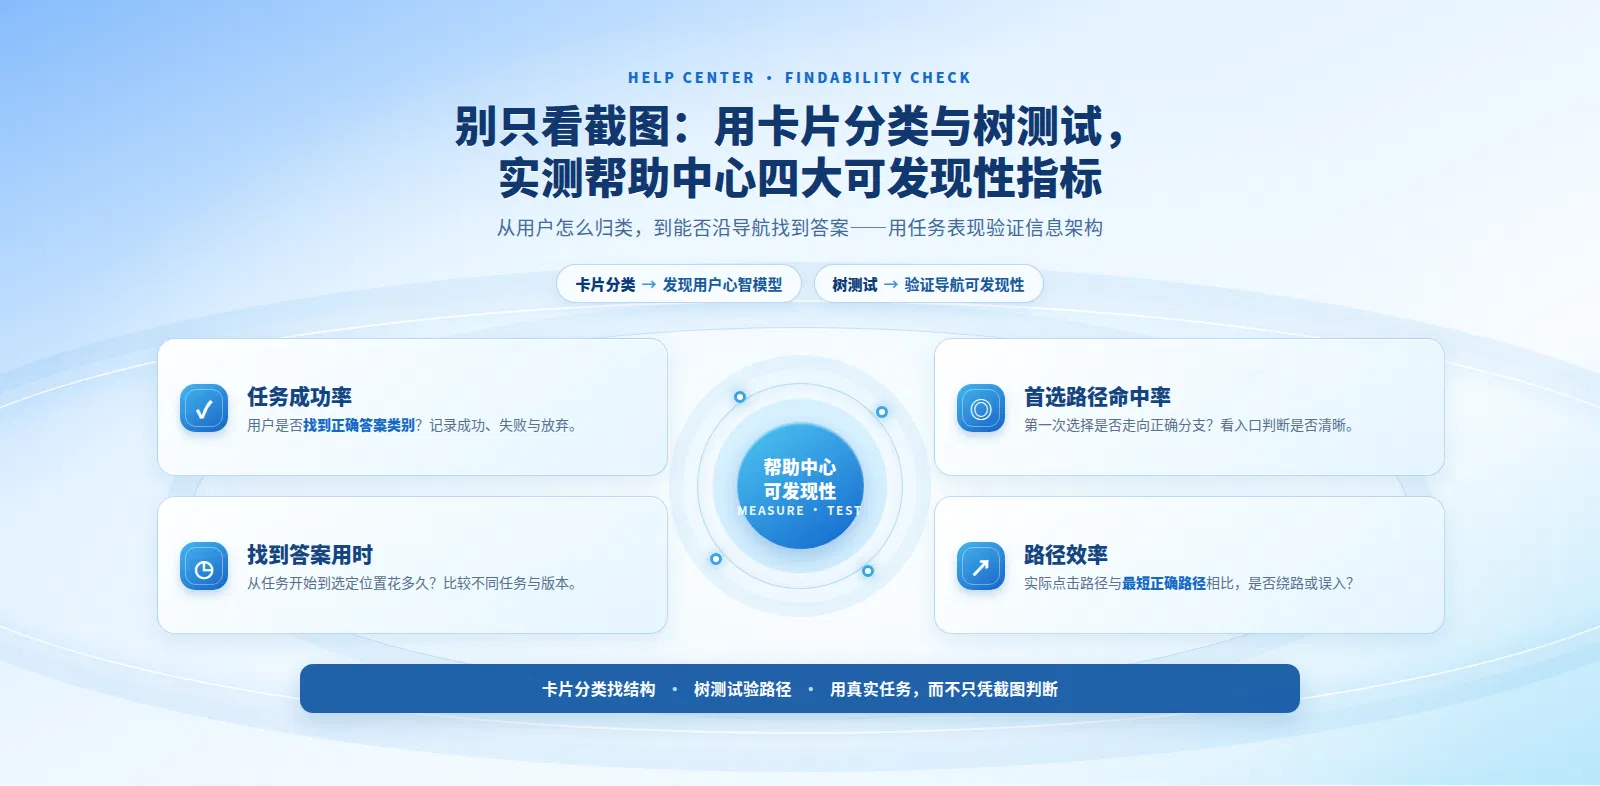
别只看截图:用卡片分类与树测试,实测帮助中心四大可发现性指标 测试帮助中心可发现性的具体指标包括用户选对分类、理解集合名称、通过面包屑成功回退及搜索无结果后找到替代路径,需通过卡片分类或树测试收集数
测试帮助中心可发现性的具体指标包括用户选对分类、理解集合名称、通过面包屑成功回退及搜索无结果后找到替代路径,需通过卡片分类或树测试收集数据验证。
为什么不能只看截图?揭秘可发现性评估的核心逻辑
仅凭产品截图无法判断真实可发现性,因为界面设计意图掩盖了用户实际行为结果,必须通过实测评估导航、搜索优先级与层级治理的真实效率。
厂商宣传的 Zendesk 或 Intercom 界面,往往只展示了“设计意图”,却掩盖了真实的“用户结果”。你无法仅凭产品截图判断面包屑是否好用、搜索优先级是否合理,或是层级治理是否真正提升了效率。
现有材料虽然能描述内容层级结构,缺乏系统性数据来证明某平台在导航或搜索指标上的绝对优势 [1][2][3][4]。这意味着任何关于”Zendesk 更适合层级治理”或”Intercom 更擅长对话式发现”的说法,目前都只是待检验的假设,而非既定事实 [1][2][3][4]。NN/G 等指南推荐了卡片分类与树测试等方法,但并未提供具体的实验样本或任务结果数据 [5]。因此,将抽象的可发现性拆解为可观测的具体行为指标,才是唯一可靠的路径。
你需要关注的是用户实际表现出的行为,而非产品的静态展示。真正的评估应聚焦于:用户能否选对分类?是否理解集合名称的含义?能否通过面包屑成功回退?以及在搜索无结果时能否找到替代路径 [5][6][7]。这些指标必须通过实测验证,而不能依赖厂商文档中的规则描述 [1][2][3][4]。帮助中心信息架构的核心在于解决具体问题,而非由单一组件承担所有责任 [5][6][7]。
实战避坑:新手常把“标签错误”误判为“搜索失效”在实施测试时,很多团队习惯直接观察用户“搜不到”的结果,便急于优化搜索引擎算法或调整关键词权重。然而,一个极易被忽视的真相是:用户搜不到答案,往往是因为他们根本不知道正确的入口在哪里,或者在点击搜索结果前就已经因为分类名称不匹配而放弃了寻找。例如,当用户在首页输入“退款”却找不到结果时,问题可能不在搜索索引,而在于“账户设置”下的子分类被命名为“资金结算政策”,导致用户连进入该分类的决策都未能做出。因此,在分析失败案例时,必须先回溯用户的浏览路径——如果他们在进入搜索框之前就在导航树上徘徊过久或直接放弃,那么根源通常是命名理解或分类逻辑的问题,而非搜索技术的缺陷。这种归因顺序的颠倒,是新手在评估可发现性时最常栽跟头的地方。
如何定义可观测指标?四大关键维度拆解
可发现性测试的四大核心行为指标
评估信息架构不看截图,看用户能否完成以下四个关键动作:
1.
分类准确率 (Category Selection): 用户能否在 3 次点击内选中包含目标答案的正确路径(目标重合率需 >85%)。
2.
命名理解度 (Naming Comprehension): 用户是否能准确理解 Collection/Section 名称的含义,而非靠猜测。
3.
回退流畅性 (Breadcrumb Navigation): 迷路时,能否通过点击面包屑迅速回到上一级并重新定位。
4.
搜索容错路径 (Search Recovery): 当搜索无结果时,系统是否提供了相关推荐或人工入口等兜底方案。
可观测指标是将模糊的使用体验拆解为四个可直接测量的行为维度,重点考察用户能否在帮助中心完成分类选择、路径回退等具体动作。
别盯着导航栏截图发呆,真正的可发现性藏在用户能否完成具体动作里。要评估帮助中心信息架构,你得把模糊的“好不好用”拆解成四个能直接测量的行为指标[5]。
1. 分类选择:用户能否准确选中目标
用户进入首页后,能否在三次点击内找到包含其问题的分类?如果大量用户在“产品功能”和“账户设置”之间犹豫或点错,说明分类逻辑混乱。合格的标准是:用户选中的路径与预设的目标路径重合率超过 85%[6]。
2. 命名理解:是否读懂 Collection 含义
不要假设用户懂你的专业术语。当你在测试中让用户寻找”API 集成指南”时,如果他们因为标题叫“开发者资源”而放弃,这就是命名失效。你需要观察用户是否根据字面意思去猜,还是真正理解了集合名称背后的意图[7]。
3. 位置感知:面包屑回退是否顺畅
用户迷路时,面包屑不仅是装饰,更是救生索。合格的指标是:用户点击面包屑回到上一级节点的成功率,以及他们是否能在回退后迅速重新定位方向。如果用户必须刷新页面或手动输入 URL 才能继续,说明层级结构断裂[5]。
4. 容错路径:搜索无结果后的替代方案
当用户搜不到答案时,系统是否提供了出路?合格的帮助中心不会只展示“未找到结果”,而是能推荐相似话题、引导至热门分类或提供人工入口。这一指标衡量的是系统在极端情况下的兜底能力[6]。
失败诊断:回归具体任务而非单一组件
很多团队习惯把问题甩锅给某个组件:“搜索不行”或“导航太深”。这种归因是错的。测试帮助中心可发现性的具体指标有哪些,关键在于结合具体任务场景诊断,不能由某一种组件单独背负责任[7]。
比如用户没找到内容,可能是因为分类名字起错了(命名问题),也可能是因为搜索关键词不匹配(搜索问题),或者是面包屑断链导致无法回退(结构问题)。只有把指标落实到具体任务流中,你才能看清真相。这些指标是研究设计的方向,用于验证设计假设,而非已被现有来源完全验证的产品效果[5][6]。在证据不足的位置,厂商文档只能证明设计意图,不能代替用户真实结果[1]。
本章执行检查清单
[ ] 确认测试任务包含“查找特定分类”环节
[ ] 记录用户对 Collection/Section 名称的困惑点
[ ] 统计面包屑点击后的有效回退率
[ ] 模拟搜索无结果场景,检查替代路径是否存在
[ ] 将失败案例按任务流程归类,而非按组件归类
用什么方法收集数据?实施步骤详解
收集数据需执行从理论到实操的验证流程,利用真实用户行为数据戳破看似合理的设计假设,而非依赖静态截图或厂商宣传。
别拿截图当结论,真正的评估必须跑通一套从理论到实操的验证流程。你需要用真实用户的行为数据,去戳破那些“看起来合理”的设计假设[5]。
构建可执行的评估流程
第一步,选定工具。NN/G 学习指南明确推荐卡片分类与树测试方法,它们能直接暴露信息架构中的导航盲区[5]。卡片分类帮你确认用户是否能把文档归入正确的集合,树测试则能测出他们在纯文本层级中能否找到目标路径[5]。
第二步,设计实验要素。不要凭感觉选人,需明确样本量、具体任务及衡量指标。你要设定清晰的场景:比如“请帮用户找到退款政策”,并规定成功标准是用户在三步内选中正确分类[5]。如果任务失败,记录他们是在哪个节点卡住,或者是否误读了 Collection 名称[6]。
第三步,验证核心假设。这一步的关键是用数据回答具体问题:用户能否理解命名含义?面包屑回退是否顺畅?搜索无结果后是否有替代路径?这些指标不是厂商宣传里的功能列表,而是用户实际操作的成败证据[7]。任何关于“层级治理”或“对话式发现”的断言,在缺乏实测数据前都只是待检验的猜想[1]。
案例多元化补充:跳出 SaaS 巨头的思维定势在进行树测试或卡片分类时,许多团队会下意识地以 Zendesk 或 Intercom 作为参照系,试图复现大厂的结构。但这往往会带来“幸存者偏差”,因为大厂的导航往往经过了数年的迭代和用户数据的喂养。为了获得更客观的基准,建议引入非同类产品的案例进行对比测试。例如,你可以参考 GitHub 或 Notion 这类以“开发者”或“知识管理”为核心场景的平台,观察它们如何处理极度扁平化的文档层级;或者参考 Shopify 的商家后台,看其如何在复杂的电商业务逻辑中维持清晰的导航路径。通过对比不同行业、不同复杂度背景下的成功案例,你能更敏锐地识别出当前帮助中心设计中哪些是“通用最佳实践”,哪些只是“特定平台的惯性操作”。这种跨领域的视角迁移,能有效避免陷入单一产品生态的盲目模仿。
本章执行检查清单
[ ] 已选定卡片分类或树测试作为核心工具
[ ] 实验任务描述清晰(如:查找特定文档)
[ ] 成功标准已量化(如:点击次数≤3 次)
[ ] 已排除仅靠截图对比的伪评估
[ ] 数据收集聚焦于分类选择与回退路径
总结:构建以用户行为为核心的帮助中心信息架构
构建以用户行为为核心的信息架构需将分类秩序、导航回退与搜索触达视为支撑可发现性的整体骨架,拒绝仅比较界面美观度的无效评估。
分类提供秩序,导航负责回退,搜索打通触达[5][6][7]。这三者不是孤立的功能,而是支撑可发现性的骨架。别再盯着产品截图比划谁的主页更漂亮,那只是厂商的设计意图,不是用户的真实结果[1][2]。
真正的检验只有一种:实测。你必须把抽象的可发现性拆解成具体动作——看用户能否选对分类,是否理解集合名称,能否通过面包屑成功回退,以及在搜索无果时能否找到替代路径[5][6]。只有当这些行为数据达标,设计假设才算成立。
立即停止单纯比较产品截图的无效工作。转向关注用户实际行为数据,用卡片分类与树测试方法收集证据,让真实表现说话[3][4]。记住,在证据不足的位置,任何关于平台优劣的断言都只是待检验的假设。构建帮助中心信息架构的关键,在于将可发现性从概念转化为可观测的行为指标,确保每一个设计决策都经过真实数据的严格检验。
FAQ: 关于可发现性测试的常见问题
Q: 为什么我的帮助中心搜索功能很强,但用户还是找不到东西?A: 这通常是因为“可发现性”不仅仅依赖搜索框。如果信息架构(IA)混乱,用户甚至不知道去哪里搜,或者搜到的结果因为分类标签错误而无法被识别。你需要结合卡片分类与树测试方法来优化顶层结构,而不仅仅是调优搜索引擎算法。
Q: 测试帮助中心可发现性的具体指标有哪些最优先?A: 没有绝对的“第一”,但通常“分类选择成功率”和“面包屑回退流畅度”是最基础的。如果用户连一级分类都选不对,后续的搜索和深度阅读就无从谈起。建议优先监控这两个维度的转化漏斗。
Q: 如何低成本进行帮助中心信息架构评估?A: 不需要昂贵的实验室设备。你可以利用远程测试工具,邀请少量目标用户(5-8 人)进行卡片分类与树测试方法的轻量级实践。让他们口头描述他们会如何查找特定内容,并记录他们的点击路径和犹豫时刻,这往往比复杂的后台数据分析更能揭示本质问题。
参考来源
Organizing knowledge base content in categories and sections – Zendesk help · https://support.zendesk.com/hc/en-us/articles/4408845897370-Organizing-knowledge-base-content-in-categories-and-sections(A级)
Workflow: Display an article or section in multiple sections or categories – Zendesk help · https://support.zendesk.com/hc/en-us/articles/4408893893018-Workflow-Display-an-article-or-section-in-multiple-sections-or-categories(A级)
Create collections in your Help Center | Intercom Help · https://www.intercom.com/help/en/articles/56647-create-collections-in-your-help-center(A级)
Help Center explained | Intercom Help · https://www.intercom.com/help/en/articles/56640-help-center-explained(A级)
Information Architecture: Study Guide - NN/G · https://www.nngroup.com/articles/ia-study-guide/(A级)
Low Findability and Discoverability: Four Testing Methods to Identify the Causes - NN/G · https://www.nngroup.com/articles/navigation-ia-tests/(A级)
Breadcrumbs: 11 Design Guidelines for Desktop and Mobile - NN/G · https://www.nngroup.com/articles/breadcrumbs/(A级)